128K 超长上下文窗口
支持单次载入海量代码库与百页级技术规范,跨文件依赖与长程逻辑推理精准无遗漏。
DeepSeek官网旗下的 DeepSeek-R1 与 DeepSeek-V3 模型依托原生 Multi-head Latent Attention(MLA)架构,在奥赛级数理推导、全栈代码工程、超长文献精读及多语言生成场景中展现出卓越的推理密度与响应效率。
无论是通过 DeepSeek网页版进行交互式科研验证,还是基于 DeepSeek api开放平台构建自动化智能体工作流,均可享受到硬盘级上下文缓存带来的低成本高吞吐算力支持。
| 能力维度 | 评测基准 | DeepSeek-R1 | DeepSeek-V3 | OpenAI o1-1217 | Claude 3.5 Sonnet |
|---|---|---|---|---|---|
| 数学竞赛 | AIME 2024 (Pass@1) | 79.8% | 39.2% | 79.2% | 16.0% |
| 高阶数理 | MATH-500 (Pass@1) | 97.3% | 90.2% | 96.4% | 78.3% |
| 代码工程 | Codeforces (Percentile) | 96.3% | 58.7% | 96.6% | 20.3% |
| 通用推理 | MMLU-Pro (Exact Match) | 84.0% | 75.9% | 81.6% | 78.0% |
| 中文语境 | C-Eval (Zero-Shot) | 91.8% | 90.1% | 85.4% | 86.8% |
支持单次载入海量代码库与百页级技术规范,跨文件依赖与长程逻辑推理精准无遗漏。
DeepSeek api开放平台自动复用高频系统提示词与长文档前缀,推理输入成本最高直降 90%。
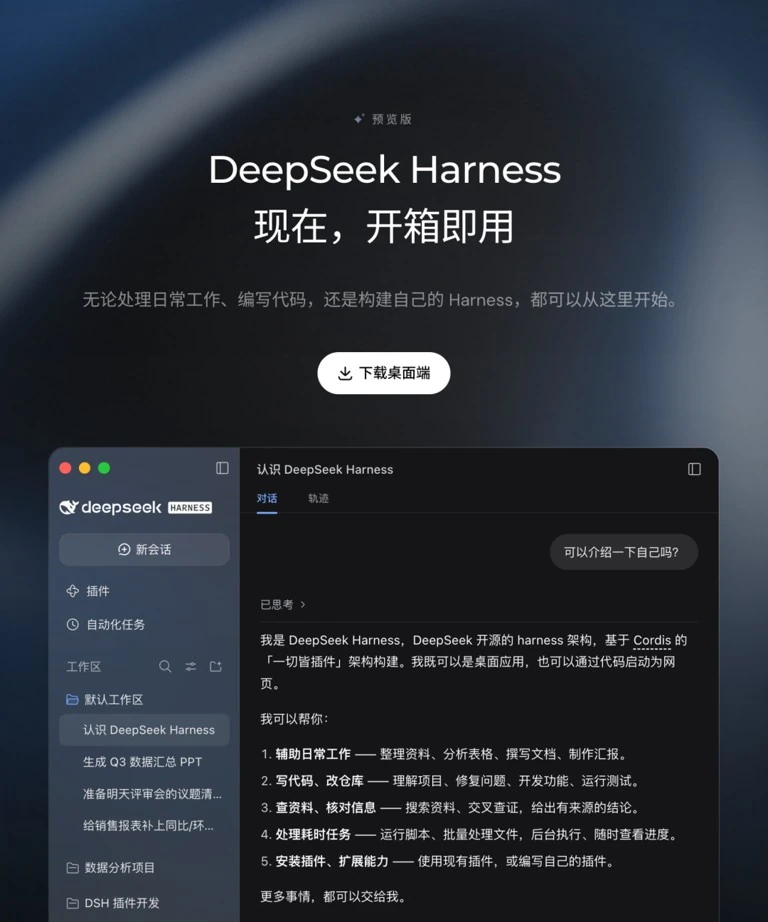
遵循 MIT 协议开放模型权重与 DeepSeek Harness 套件,无缝支持 vLLM 及 SGLang 专有云落地。